Jina Reader: LLM'e sayfa okuturken temiz veri ve SSRF koruması
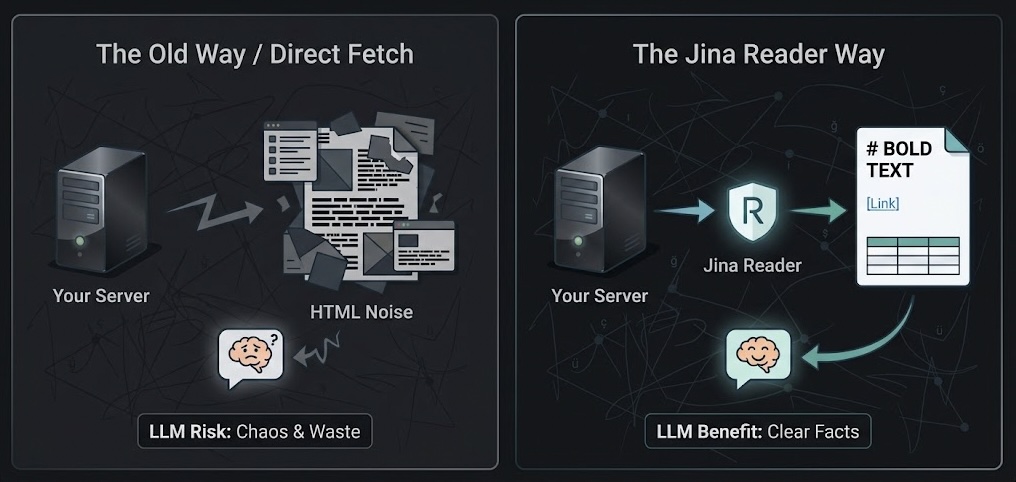
Jina Reader, bir web sayfasını LLM'in okuyabileceği temiz bir metne çeviren bir servis. Kullanımı tek satır: okutmak istediğiniz adresin başına https://r.jina.ai/ ekliyorsunuz ve sayfanın markdown hâlini alıyorsunuz. Bir LLM'e web sayfası okutan bir akış, bir ajan ya da bir n8n workflow'u kuruyorsanız bu yazı sizin için. Jina'yı kullanmak için iki iyi sebep var: model daha temiz veri alıyor ve sunucunuz iç ağa açılmıyor.
Nasıl çalışıyor
İstek sayfanın adresini olduğu gibi taşıyor:
curl https://r.jina.ai/https://www.anthropic.com/claude-haiku-5-5
Cevap düz metin olarak geliyor. Başta sayfanın başlığı, kaynak adresi ve varsa yayın tarihi yazıyor, ardından içerik markdown olarak geliyor. Başlıklar # işaretiyle, linkler [metin](adres) biçiminde ve tablolar markdown tablosu olarak duruyor. Menüler, kenar çubukları ve script'ler ayıklanmış oluyor. Bir API anahtarı ya da kurulum gerekmiyor.
Jina sayfayı varsayılan olarak headless bir tarayıcıda, yani ekranı olmadan çalışan bir tarayıcıda açıyor. Sayfadaki JavaScript çalıştıktan sonra metni çıkarıyor. Daha hızlı ama JavaScript çalıştırmayan düz bir HTTP seçeneği de var; hangisinin kullanılacağını X-Engine header'ıyla seçebiliyorsunuz.
Birinci sebep: temiz veri
Bir sayfayı kendiniz çektiğinizde elinize HTML geçiyor. İçinde menüler, script'ler, stil tanımları ve takip kodları var. Bunları ayıklamadan modele verirseniz token'ın büyük kısmını gürültüye harcıyorsunuz. Ayıklamak için de her sitenin yapısına göre ayrı kural yazmanız gerekiyor.
Fark bir örnekte açıkça görülüyor. Anthropic'in Claude Haiku 5.5 duyurusu ham HTML olarak 220 bin karakter tuttu. Aynı sayfa Jina'dan 7,5 bin karakterlik temiz bir metin olarak geldi. Benchmark ve fiyat tabloları da markdown tablosu olarak korunmuştu, yani model rakamları doğrudan tablodan okuyabiliyordu.
JavaScript ile yüklenen sayfalarda fark daha da büyük. Mastodon gibi sitelerde içerik sayfa açıldıktan sonra JavaScript ile yükleniyor. Böyle bir gönderi doğrudan çekildiğinde HTML'den yalnızca başlık çıkıyor. Jina ise gönderinin tam metnini getiriyor.
Bunun sonuç üzerinde doğrudan etkisi var. Model yalnızca başlığı gördüğünde boşluğu kendi bildikleriyle dolduruyor. Claude Haiku 5.5 hakkında yazdırılan bir metinde modelin adı "Haiku 3.5" olarak geçti, çünkü kaynakta ona yetecek bir metin yoktu. Sayfanın gerçek içeriği verildiğinde metinler fiyat, hız ve özellik gibi kaynaktaki somut bilgilere dayanıyor.
İkinci sebep: SSRF
Bir LLM akışında linkleri genellikle siz seçmiyorsunuz. RSS feed'lerinden, kullanıcılardan ya da başka bir servisten geliyorlar. Bu linkleri açan sizin sunucunuz. Sunucunun önemli bir özelliği var: internetten kimsenin erişemediği iç adreslere ulaşabiliyor. Bu açığın adı SSRF (Server-Side Request Forgery), yani sunucuya sizin adınıza istemediğiniz bir istek attırmak.
Sorun nasıl ortaya çıkıyor
Sunucunun erişebildiği iç adresler arasında yönetim panelleri, aynı ağdaki veritabanları ve servisler var. Bulut sunucularının çoğunda bir de 169.254.169.254 adresinde çalışan bir metadata servisi bulunuyor. Bu servis sunucu hakkında bilgi veriyor ve kuruluma göre gizli bilgiler de döndürebiliyor.
Dışarıdan normal görünen bir link bu adreslerden birine çıkarsa zincir şöyle işliyor:
flowchart LR
    Feed[Feed linki] --> Sunucu[Sizin sunucunuz]
    Sunucu --> Ic[Ic adres: panel, metadata]
    Ic --> Sunucu
    Sunucu --> LLM[LLM]
    LLM --> Cikti[Uretilen taslak]
İç adresteki bilgi önce sizin sunucunuza, oradan LLM'e, oradan da ürettiğiniz metne gidiyor. Bir taslağın içinde sunucunuza ait bilgilerin görünmesi için tek bir kötü niyetli link yetiyor.
Gerçek örnekler
En bilinen örnek 2019'daki Capital One sızıntısı. Bir saldırgan, AWS üzerinde çalışan ve yanlış yapılandırılmış bir web uygulama güvenlik duvarı üzerinden metadata adresine istek attırdı. Oradan aldığı geçici kimlik bilgileriyle S3'teki dosyalara erişti ve yaklaşık 100 milyon müşteri kaydını indirdi.
LLM ajanları aynı açığı yeniden üretiyor, çünkü web sayfası okuyan araçları çoğunlukla bu kontrollerle yazılmıyor. 2026'da PraisonAIAgents kütüphanesinin web_crawl fonksiyonu için bir CVE (CVE-2026-40150) yayınlandı. Fonksiyon sayfayı çekmeden önce adresin iç ağa ait olup olmadığına bakmıyordu, böylece metadata adresine ve iç servislere istek atılabiliyordu. Ajanlarda bir risk daha var: okunan sayfanın içine gizlenmiş talimatlar, yani prompt injection, ajanı bu tür iç adresleri açmaya yönlendirebiliyor.
Neden URL kontrolü yetmiyor
İlk akla gelen çözüm, linki açmadan önce adresi kontrol etmek. localhost, 127.0.0.1 ve 192.168.x.x gibi açıkça iç olan adresleri engellemek kolay. Basit bir kontrol bu adreslerin hepsini yakalar.
Ama bu kontrol linkte yazan adrese bakıyor. Dışarıdan normal görünen bir alan adının hangi IP'ye çözüldüğünü göremiyor. Bir saldırgan kendi alan adını iç bir IP'ye yönlendirirse kontrol bunu fark etmiyor. Kontrolden sonra DNS kaydını değiştirip isteği iç adrese çevirmek de mümkün. Bu yönteme DNS rebinding deniyor. Kontrol, n8n'in Code node'u gibi DNS sorgusu yapamayan bir ortamda çalışıyorsa bu açığı orada kapatmanın bir yolu da yok.
Jina ile ne değişiyor
Jina kullandığınızda sunucunuz feed'den gelen linke hiç bağlanmıyor. Yalnızca sabit bir adrese, r.jina.ai'ye istek atıyor. Linki açan Jina'nın sunucusu oluyor ve onun sizin iç ağınıza erişimi yok. Jina kendi tarafında da iç adreslere giden istekleri reddediyor. Metadata adresine istek gönderildiğinde Jina isteği "Request to localhost or non-public IP" diyerek geri çeviriyor.
URL kontrolünü yine de yerinde bırakmakta fayda var. İkinci bir katman olarak duruyor ve açıkça iç olan adresleri Jina'ya hiç göndermiyor.
Sınırları
Okunan sayfalar üçüncü taraf bir servisten geçiyor. Herkese açık haber sayfaları için bu sorun değil. Giriş gerektiren ya da şirket içi sayfalar için Jina'yı kullanmamak gerekiyor.
Anahtarsız kullanımda dakikada 20 istek sınırı var. Jina'dan ücretsiz bir anahtar alırsanız sınır dakikada 200'e çıkıyor, daha fazlası için ücretli planlar var. Günde birkaç düzine sayfa okuyan bir akış bu sınırın çok altında kalır.
Jina'ya bağımlı hale geliyorsunuz. Servis yavaşlarsa ya da kapanırsa sayfa okuma adımı hata veriyor. Akışı, okuma başarısız olduğunda başlık ve özetle devam edecek şekilde kurmak bu yüzden iyi bir önlem.
Klasik çözüm hâlâ geçerli: sunucunun dışarı giden trafiğinde iç adres aralıklarını ve metadata adresini bir güvenlik duvarı kuralıyla engellemek. Bu, Jina'ya bağımlı olmadan aynı korumayı sağlıyor. Docker ve Coolify gibi bir kurulumda kuralı container ağına göre dikkatle yazmak gerekiyor, çünkü yanlış bir kural uygulamanın kendi veritabanına ulaşmasını da kesebiliyor. AWS kullanıyorsanız metadata servisinde IMDSv2'yi zorunlu kılmak da yardımcı oluyor. IMDSv2 önce bir oturum anahtarı istiyor ve bunu ancak özel bir header'la gönderilen bir PUT isteği alabiliyor. Basit SSRF açıkları ise çoğunlukla yalnızca GET isteği atabiliyor.
Hangi durumda hangisi
| Senaryo | İlk tercih | Alternatif |
|---|---|---|
| Herkese açık sayfaları LLM'e okutmak | Jina Reader | Doğrudan çekme ve güvenlik duvarı |
| Giriş gerektiren ya da iç sayfalar | Kendi ağınızda doğrudan çekme | — |
| Dakikada yüzlerce sayfa | Kendi okuyucunuz ve güvenlik duvarı | Jina'nın ücretli planı |